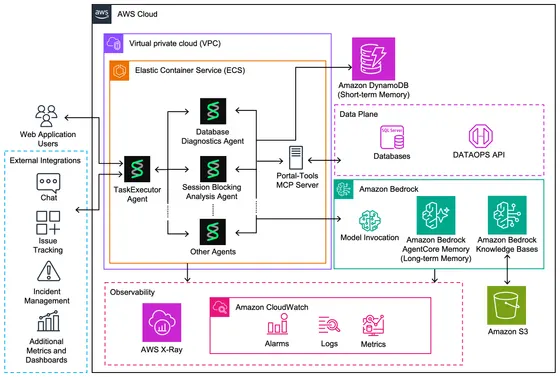
AWS博客披露,Cornerstone OnDemand的Orion AI将单次数据库故障诊断从45分钟降至10分钟,手动生命周期步骤减少70%,重复告警中位数减少65%。该系统由三人团队在六个月内完成。
阅读全文从新闻再向前一步,读懂技术背景与产业影响。
AWS博客披露,Cornerstone OnDemand的Orion AI将单次数据库故障诊断从45分钟降至10分钟,手动生命周期步骤减少70%,重复告警中位数减少65%。该系统由三人团队在六个月内完成。
阅读全文ByteByteGo发布的文章引用Netflix公开分享的细节,称Netflix工程团队构建了GenRec,将开源基础大语言模型用Netflix专有数据适配后,通过两阶段训练和prefill-only推理为电影、剧集等内容打分排序,以替代数千个手工特征。
阅读全文Musubi称该模型可在 50 毫秒内将自然语言写成的社区政策应用到消息上,无需针对新政策重新训练,并以开放权重发布。
阅读全文OpenAI官网发布的一则案例介绍称,Jump Trading使用其模型扩大量化研究,并把多数据源、运行时间更长的AI工作流与人工复核结合起来;来源未披露效率、准确率或部署规模等数据。
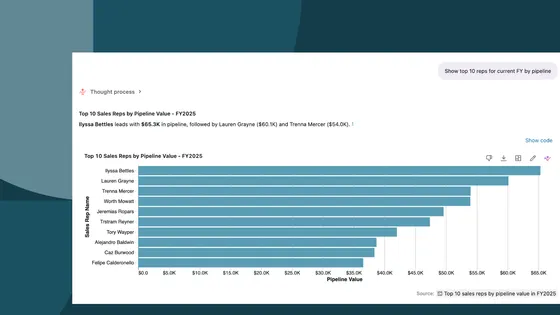
Databricks博客称,2026年至今客户已创建超过100万个Genie Agent,多数数据团队的问题已从“能不能建”变成“先建哪个”。其基于金融、能源、零售等行业数十次部署经验给出的筛选框架称,选错工作流是试点失败最常见的原因,而“没有业务负责人”的项目无论得分多高都不该启动。
OpenAI新闻稿称,Albertsons Companies正使用ChatGPT Enterprise和OpenAI API,帮助团队更快工作,并让数百万顾客的购物更简单。
Apple与EPFL合作论文发现,在相同前沿LLM底座和相同时间预算下,开源最先进的多智能体框架并未跑赢一个仅用read/write/bash原语的极简编码智能体。
Databricks联合OpenAI和Stellantis讨论agentic应用的生产化问题,提出用Agent Bricks、Omnigent、Unity Gateway共享基础设施,避免每个团队各自接线导致集成重复、策略不一致和成本上升。
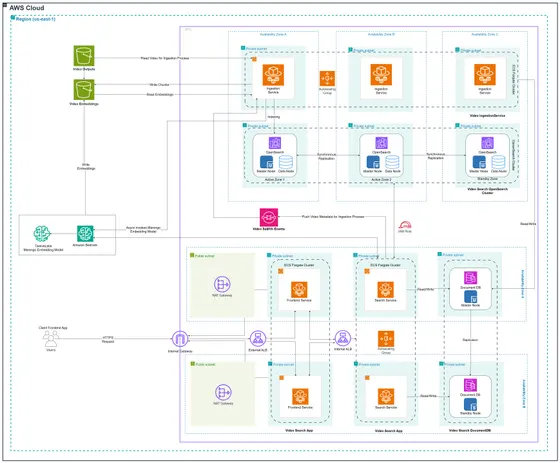
康泰纳仕编辑团队此前检索一条视频平均要花 250 分钟,只能在 14 万多条视频的库里靠标题和描述手动翻找。它和AWS生成式AI创新中心合作,用TwelveLabs Marengo嵌入模型和亚马逊OpenSearch搭出一套多模态检索方案,按AWS博客披露的数据,单次任务检索时间降到约 2 分钟。
Jason Garfield在荷兰两天的比赛里,第一晚满座、第二晚侧机位拍到成排空座;他用Runway的Aleph 2.0往已有画面里加人,并从头生成排行榜、选手卡和舞台烟火,整套约一小时特别节目由他一人剪辑完成。

Databricks公开其内部模型发布流程:新模型当天对全员开放但标记为实验性,用按用户预算限制用量,三天内根据内部基准、用户反馈和成本追踪决定是否转正。
GitHub安全实验室用开源Taskflow Agent审计Android应用,报告了 24 个漏洞,包括OsmAnd可被任意应用静默导入设置以追踪位置,以及Wikipedia应用通过deeplink实现账户接管。

波士顿语音智能公司Modulate完成 2500 万美元新融资,由Future Ventures领投;其平台用 100 多个小模型做转录、情绪分析、深度伪造与AI音乐检测,以及受监管行业语音智能体的合规执行。

Anthropic发布Claude Sonnet 5.5,在Artificial Analysis智能指数上得分 56,仅次于Opus 5.5 (max),但每任务输出token高达约 19.3 万,成本约 7.60 美元/任务,比Sonnet 5高出约 50%。

TrackAbout客户合计管理 2750 万件资产、每月处理超 72.5 万张账单;过去租赁分析依赖IT生成SSRS报告,等待数天到数周。Datacor用跨云管道、多租户行级安全和自然语言查询把分析搬进应用内,2025 年 11 月正式发布。

一篇刊登于AI News的实操文章提出,AI应作为新增层而非新地基;用API中间层、RAG、事件驱动和Strangler Fig四种模式把模型与核心系统隔开,并建议先从搜索、摘要、报表等只读场景起步。
The Verge采访的多位研究者指出,严格气隙隔离会降低评测的真实性、拖慢研究速度,而且无法消除模型内部风险,也无法保证隔离永远密封。

Hugging Face博客发布NVIDIA撰写的教程,介绍如何把经典MuJoCo场景迁移到基于Warp的MJWarp,让同一套MJCF模型在GPU上批量推进,最多同时运行 2048 个独立仿真世界。
SWE-Serve用 53 个来自SGLang已合并PR的任务,测量AI编码代理在推理服务栈上的真实表现。19 个需要启动真实服务器的任务里,约三分之一补丁在排除实时服务测试时通过、加入后失败。

OpenAI新闻页摘要称,invideo借助GPT-6 Astra更精确地规划剪辑,将颜色校正与调色效率提升三倍,并在一天内产出 50 个自定义效果。
苹果在Machine Learning Research博客发文介绍probe guidance,利用扩散模型冻结的内部状态构建引导信号,无需推理时额外前向传播,在连续扩散语言模型的无条件生成上取得新最优,并在 1.7B模型上提升了多项选择题基准
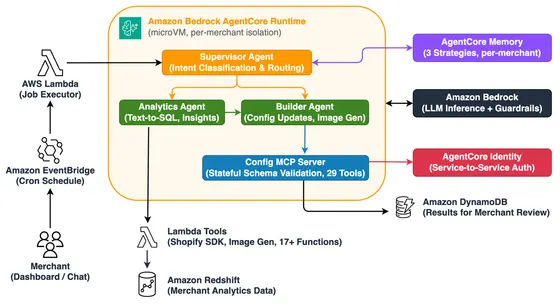
AWS博客披露:Reactiv基于Amazon Bedrock AgentCore搭建三智能体系统,商家用自然语言设定每周更新计划,系统自动生成配置,但上线前仍需商家审批。
ByteByteGo与GPT Voice团队工程师对谈,梳理全双工语音的三代架构、实时推理工程,以及p95指标为何在连续流场景下失效。

特灵科技在 3 至 4 周内构建智能体,将原本需要多屏导航 20 分钟以上的楼宇诊断操作,变成一次自然语言对话,内部实测时间缩短至 20 秒,效率提升 60 倍。
36氪在上海举办2026 East Forward出海大会,讨论重心从“怎么出去”转向“怎么留下来”;掌阅科技CEO孙凯披露AI短剧成本与供给数据,Shopify、长安汽车等分享各自路径。
Artificial Analysis测得Opus 5.5在最高effort下智能指数得分 58,为历史最高;Anthropic同步将输入输出价格降至每百万token 4美元/20 美元,缓存读取降至 0.20 美元。

AISI将HealthBench、FrontierMath、Humanity's Last Exam、SWE-Bench Pro和Terminal-Bench 2.0的验证结果、上下文与配置信息发布在Evaluation Cards上,覆盖Claude Opus 4至4.6和GPT-5至5.4六个前沿模型。
英伟达在博客中介绍其物理AI安全体系Halos,涵盖DRIVE AGX Thor、Halos OS、IGX Thor等组件,并给出ABI Research与Omdia对2035年前自动驾驶和工业机器人装机量的预测。
AI News转载的一篇客座分析文章指出,企业AI采用速度已超过治理速度,传统监控工具无法识别AI活动,影子AI、SaaS内嵌AI和自主智能体构成三类不同风险。